

Open-Source-Innovation in der Praxis: Der neue S3-Filebrowser für das Stackable Cockpit
In den vergangenen Monaten (April bis Oktober 2026) hatten wir beide, Daniel Kleiber und Felix Ivo von der ORDIX AG, die spannende Aufgabe, als Open-Source-Contributors maßgeblich an der Erweiterung des sogenannten Stackable Cockpits mitzuwirken. In enger Zusammenarbeit mit dem Team der Stackable GmbH, das uns mit Code-Reviews und Brainstorming zur Seite stand, haben wir vor allem ein zentrales Feature entwickelt: Einen vollumfänglichen, in das Cockpit integrierten S3 Filebrowser.
Der Hintergrund für dieses Projekt ist, dass die Orchestrierung moderner Dateninfrastrukturen oft von steilen Lernkurven und komplexen Kommandozeilen-Werkzeugen geprägt wird. Plattformen, die diese Komplexität abstrahieren, gewinnen daher zunehmend an Bedeutung. Ein gutes Beispiel hierfür ist die Stackable Data Platform, eine auf Kubernetes basierende Open-Source-Lösung, die es ermöglicht, eine vernetzte Dateninfrastruktur aus diversen Apache-Services nahtlos aufzusetzen. Das Stackable Cockpit bildet dabei das Herzstück der grafischen Verwaltung dieser Plattform. Es bietet Fachanwendern und Data Engineers eine unifizierte Benutzeroberfläche, um mit Cluster-Ressourcen umzugehen, ohne sich in den Tiefen der Infrastruktur zu verlieren.
Doch was kann dieses neue Werkzeug, wie wurde es technisch umgesetzt und welchen Mehrwert bietet es dem Stackable-Ökosystem?
Der direkte Vergleich: warum ein eigener S3-Browser im Cockpit?
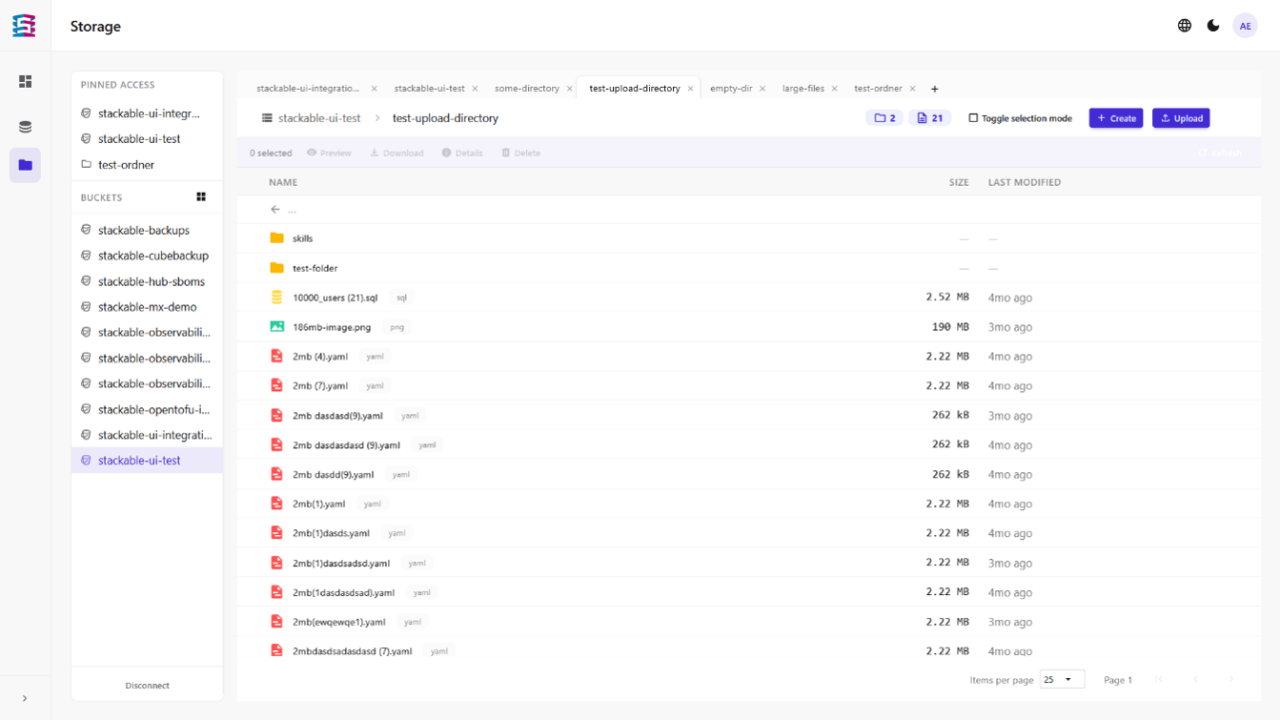
Anstatt externe Tools wie Cyberduck oder die AWS Console nutzen zu müssen, integriert der neue S3 Filebrowser die Datenverwaltung direkt in den Workflow der Stackable Data Platform. Das auf Svelte und SvelteKit basierende Projekt glänzt durch eine hohe Reaktivität und durchdachte Features, die speziell auf Data Engineering zugeschnitten sind.
Hier sind die besonderen Stärken der Neuentwicklung:
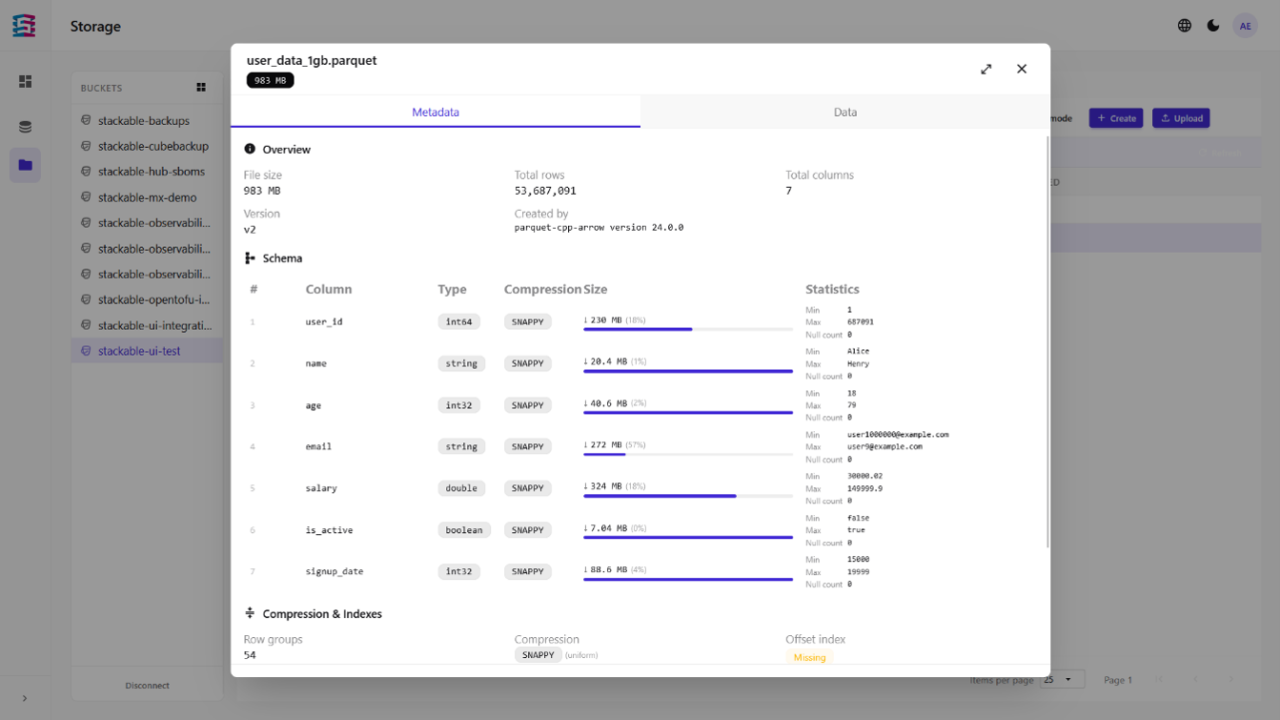
- Intelligente und sichere Dateivorschau (Previews): Data Lakes enthalten oft gewaltige Dateien. Ein 5 GB großes Log-File darf den Browser nicht zum Absturz bringen oder hohe S3 Kosten verursachen. Wir haben die Vorschau so konzipiert, dass bei Formaten wie JSON, Text oder CSV nur die ersten Bytes über Range-Requests geladen werden. Ein klares visuelles Feedback zeigt an, wenn eine Vorschau limitiert wurde. Auch für Big-Data-Formate wie Parquet haben wir eine effiziente Vorschau implementiert, die das Schema visualisiert und nach und nach die Datenreihen lädt. Dadurch werden nur wenige Kilobytes anstatt Gigabytes geladen, und somit Kosten und Ladezeiten gering gehalten.
- Hochperformante Navigation durch Svelte 5 Runes: Das Durchsuchen von S3-Buckets mit abertausenden Objekten erfordert ein exzellentes State-Management. Durch ein stabiles, reaktives State-Management auf Basis von Svelte 5 Runes und einer Cursor-basierten Paginierung ist die Navigation selbst bei riesigen Dateilisten flüssig. Hinzu kommen dedizierte Suchfunktionen für Buckets und Dateien.
- Erweiterte UX durch Tab-View: Eines der stärksten Features für Power-User ist die Tab-View-Ansicht. Anwender können nahtlos zwischen mehreren Verzeichnissen gleichzeitig operieren, was das Vergleichen, Verschieben oder Kopieren von Daten über verschiedene Pfade hinweg massiv erleichtert.
- Flexibilität im Connection Setup: Der Browser ist so gebaut, dass er verschiedenste S3-kompatible Backends unterstützt. Nutzer können flexibel zwischen Path-style und Virtual-hosted style Zugriffsarten wählen, eigene Endpunkte definieren und sich auch mit Buckets verbinden, die nicht explizit in der Grid-Übersicht gelistet sind.
Technische Realität: der Umgang mit S3-Limitierungen
- Ein spannender Aspekt bei der Entwicklung war der Umgang mit den physikalischen Gegebenheiten von S3 als Object Storage im Vergleich zu klassischen Dateisystemen.
- Move, Copy und Rename: Wir haben Funktionen wie Verschieben, Kopieren und Umbenennen implementiert. Da S3 jedoch nativ keine atomaren „Move"- oder „Rename"-Operationen für Objekte anbietet, arbeitet der Browser unter der Haube intelligent mit kombinierten Copy- und Delete-Befehlen. Diese Aktionen können bei Bedarf deaktiviert werden, da sie hohe S3-Kosten verursachen können.
- Keine echten Ordner: S3 kennt keine Verzeichnisse, nur Präfixe. Der Browser abstrahiert dies elegant weg und erlaubt sogar das direkte Anlegen von neuen (virtuellen) Verzeichnissen und simplen Textdateien über die UI, um den Workflow nicht zu unterbrechen.
Um eine durchgängige Internationalisierung und korrekte UTF-8-Standardisierung (z. B. bei der Pluralisierung von Metadaten) zu gewährleisten, haben wir zudem die Paraglide-Bibliothek tief in das Svelte-Frontend integriert.
Ein Blick über den Tellerrand: weitere Beiträge zum Stackable-Ökosystem
Während der S3 Filebrowser unser Hauptfokus im Frontend war, haben wir unsere Zeit bei dem Projekt auch genutzt, um an anderen Ecken des Cockpits mitzuwirken.
So haben wir beispielsweise ein neues Bookmark-Feature für das Dashboard entwickelt, welches andere (Apache) Service Frontends öffnet.
Ausblick: die Zukunft der Stackable UI
Das Projekt, das als leichtgewichtiger, isolierter S3-Browser gestartet ist, besitzt eine zukunftssichere Architektur, denn eine von Stackable's wichtigsten architektonischen Entscheidungen war die Einführung eines StorageBackend Interfaces, welches verschiedene Speichersysteme integrieren kann.
Auch wenn aktuell S3 die erste und einzige Implementierung ist, ist das Fundament gelegt, um in Zukunft weitere Backends wie HDFS (Hadoop Distributed File System) nahtlos in denselben Filebrowser einzubinden. Zudem arbeitet der Browser derzeit noch als Standalone-Tool im Cockpit (ohne direkte Integration der Stackable Kubernetes Custom Resources). Die Roadmap sieht vor, diese Trennung in Zukunft aufzuheben und den Filebrowser vollumfänglich in die Kubernetes-Erkennung der Plattform (SDP) einzubinden.
Fazit: erfolgreiche Open-Source-Zusammenarbeit
Unsere Arbeit am Stackable Cockpit war für uns bei der ORDIX AG eine hervorragende Gelegenheit zu zeigen, wie viel Mehrwert moderne Web-Technologien (wie SvelteKit) im stark backend-lastigen Data-Engineering-Sektor stiften können. Umso mehr war es für uns auch eine Möglichkeit an einem echten Anwendungsfall mit einer, uns neuen, Technologie umzugehen, an welcher wir beide viel gelernt haben. Die Zufriedenheit des Stackable-Teams und Kunden zeigt uns, dass wir zudem auch gute Arbeit geleistet haben.
Abschließend sehen wir, dass die Stackable Data Platform sich rasant zu einer der spannendsten europäischen Open-Source-Lösungen für Dateninfrastrukturen entwickelt. Wer das Cockpit und den neuen S3 Filebrowser selbst ausprobieren möchte, findet den Quellcode – ganz im Sinne des Open-Source-Gedankens – frei zugänglich auf GitHub unter stackabletech/cockpit. Wir können jedem Data-Team nur empfehlen, sich Stackable genauer anzusehen!
Seminarempfehlungen
STACKABLE ON-SITE WORKSHOP [STACK-01]
Mehr erfahrenSTACKABLE GRUNDLAGEN SEMINAR [STACK-02]
Mehr erfahrenDATA WAREHOUSE GRUNDLAGEN [DB-DB-03]
Mehr erfahren
Junior Consultant
Kommentare