

MySQL 9.7 LTS in der Praxis #03: Wenn ein Knoten hängt, wie heilt sich Group Replication in 9.7 selbst?
Alle Beispiele basieren auf der Beispieldatenbank Sakila und sind mit MySQL 9.7.2 Community getestet, dem zum Testzeitpunkt aktuellen offiziellen Container-Image. Für den Betrieb empfehle ich den neuesten Patchstand, derzeit 9.7.4. Enterprise-Funktionen sind nicht Teil der Serie.
Die Laborskripte für Teil 3 für Podman findet ihr hier:
Ein Secondary hängt und keiner merkt es rechtzeitig. Zuerst wächst die Warteschlange, dann drosselt Flow Control den Primary und am Ende wundert sich die Anwendung über langsame Commits. In MySQL 9.7 stehen vier Komponenten in der Community Edition bereit, die diese Situation sichtbar machen und zum Teil selbst eingreifen. Ich habe das in einem Drei-Knoten-Cluster mit Sakila nachgestellt und einen Secondary gezielt ausgebremst.
Vier Komponenten im Überblick
Die vier Komponenten waren bisher der Enterprise Edition vorbehalten. Zwei davon liefern Diagnosedaten, zwei greifen in den Betrieb ein.
- Flow Control Statistics zählt, wie oft und wie lange Flow Control den Durchsatz gedrosselt hat.
- Replication Applier Metrics zeigt im Performance-Schema, worauf der Applier wartet.
- Resource Manager überwacht Lag und Speicher der Secondaries und schließt einen Knoten aus, der dauerhaft über den Schwellwerten liegt.
- Primary Election wählt beim Failover den aktuellsten Secondary zum neuen Primary.
Alle vier Komponenten werden per INSTALL COMPONENT eingerichtet und zwar auf jedem Mitglied. Dabei bin ich im Labor über einen ersten Stolperstein gefallen. Auf einem Secondary, der bereits in der Gruppe ist, scheitert die Installation an super_read_only, weil INSTALL COMPONENT in mysql.component schreibt.
ERROR 1290 (HY000): The MySQL server is running with the --super-read-only option so it cannot execute this statement
Ich installiere die Komponenten deshalb vor START GROUP_REPLICATION und ohne Binlog-Eintrag.
SET SQL_LOG_BIN = 0;
INSTALL COMPONENT 'file://component_group_replication_flow_control_stats';
INSTALL COMPONENT 'file://component_replication_applier_metrics';
INSTALL COMPONENT 'file://component_group_replication_resource_manager';
INSTALL COMPONENT 'file://component_group_replication_elect_prefers_most_updated';
SET SQL_LOG_BIN = 1;
Das Laborszenario
Drei Container gr1 bis gr3 laufen mit MySQL 9.7.2 im Single-Primary-Modus, gr1 ist Primary, Sakila ist geladen. Auf gr3 halte ich den Applier mit FLUSH TABLES WITH READ LOCK für 180 Sekunden an. Währenddessen schreibt gr1 2.000 Transaktionen mit je zehn Zeilen in sakila.payment. Das Labor ist eine Wegwerfumgebung, Original-Sakila wird dabei verändert.
Damit im Labor überhaupt etwas passiert, habe ich die Schwellwerte drastisch gesenkt. Die Defaults liegen bei 3.600 Sekunden für den Lag und Quarantäne. Flow Control greift standardmäßig erst ab 25.000 Transaktionen in der Warteschlange. Diese Laborwerte gehören auf keinen Fall in die Produktion.
SET GLOBAL group_replication_resource_manager.applier_channel_lag = 10;
SET GLOBAL group_replication_resource_manager.quarantine_time = 120;
SET GLOBAL group_replication_flow_control_applier_threshold = 100;
SET GLOBAL group_replication_flow_control_certifier_threshold = 100;
Alle zehn Sekunden habe ich die Statusvariablen auf gr1 und gr3 sowie die Warteschlangen aus replication_group_member_stats abgefragt.
Flow Control wird messbar
Bei der zweiten Messung, gut zehn Sekunden nach Start der Last, hatte Flow Control bereits fünfmal gedrosselt.
SELECT variable_name, variable_value FROM performance_schema.global_status
 WHERE variable_name LIKE 'Gr\_flow\_control%';

+--------------------------------------------------+----------------------------+
| variable_name                                    | variable_value             |
+--------------------------------------------------+----------------------------+
| Gr_flow_control_throttle_active_count            | 0                          |
| Gr_flow_control_throttle_count                   | 5                          |
| Gr_flow_control_throttle_last_throttle_timestamp | 2026-10-21 07:31:02.570207 |
| Gr_flow_control_throttle_time_sum                | 2010043                    |
+--------------------------------------------------+----------------------------+
Die Summe von 2.010.043 Mikrosekunden bedeutet rund zwei Sekunden Drosselung. Danach stieg der Zähler nicht weiter, weil die Last bereits vollständig an die Gruppe übergeben war. Auf gr3 standen zu diesem Zeitpunkt 2.000 Transaktionen in der Applier-Warteschlange. Bisher hätte man diese Drosselung nur indirekt an langsameren Commits erkannt. Mit den neuen Zählern lässt sie sich direkt messen und überwachen. Die Werte gelten pro Mitglied und werden unter anderem bei einem Neustart oder einem erneuten Beitritt zurückgesetzt. Wer Trends sehen will, muss sie deshalb extern speichern.
Der Resource Manager greift ein
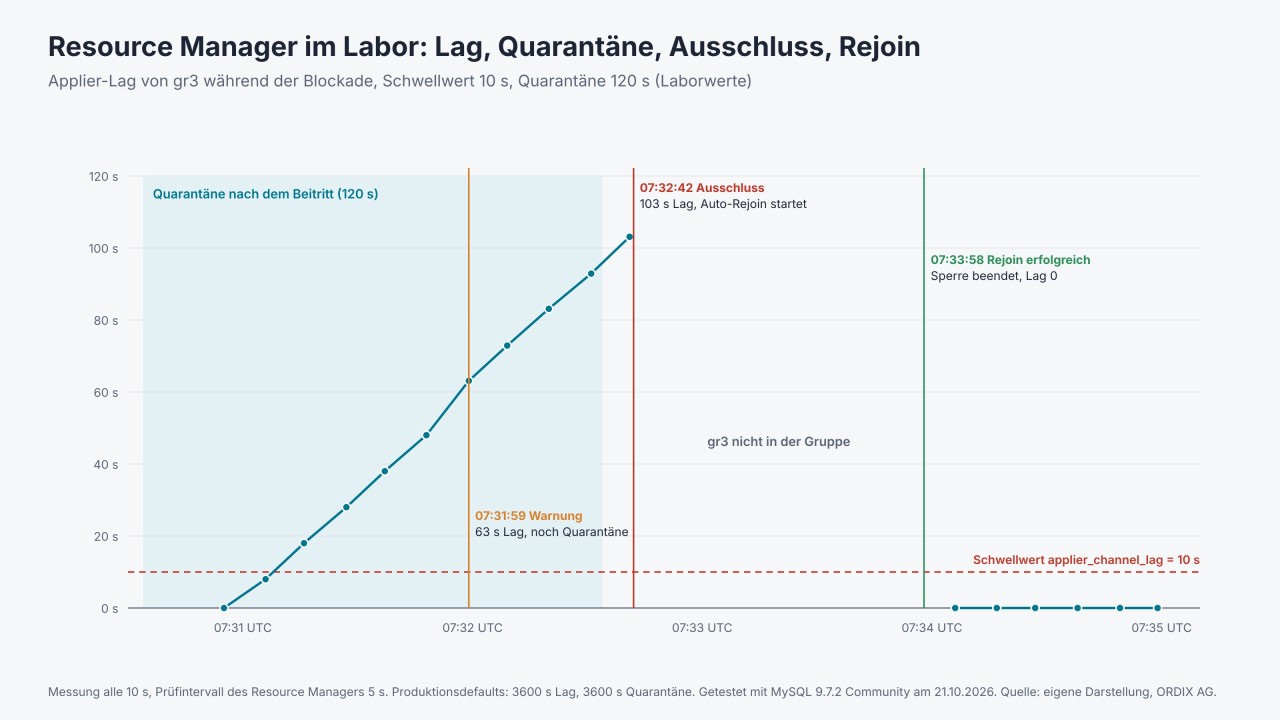
Der Resource Manager prüft auf den Secondaries alle fünf Sekunden den Lag. Ein Ausschluss erfolgt laut Doku erst, wenn der Schwellwert zehnmal in Folge überschritten ist. Die Messreihe auf gr3 passt dazu, denn der Zähler der Überschreitungen stieg um zwei pro zehn Sekunden.
Zeit (UTC)   applier_channel_lag   threshold_hits   Zustand gr3
07:31:06      8 s                   0               ONLINE
07:31:27     28 s                   4               ONLINE
07:31:59     63 s                  11               ONLINE
07:32:41    103 s                  19               ONLINE
07:32:52      0 s                  19               nicht in der Gruppe
07:34:06      0 s                  19               ONLINE
Spannend ist die Lücke zwischen 07:31:59 und 07:32:41. Nach elf Überschreitungen hätte gr3 die Gruppe verlassen müssen, stattdessen schrieb er eine Warnung ins Error Log.
[Warning] [MY-015563] [Server] Component component_group_replication_resource_manager reported:
'Member threshold exceeded: applier channel lag of 63 seconds exceeded tolerance threshold configured to 10 seconds.
However, since it joined 85 seconds ago and the quarantine period is configured to 120 seconds,
the member will not leave the group.'
Die Quarantäne schützt also nicht nur einen Knoten, der nach einem Ausschluss wieder beigetreten ist, sondern auch einen, der gerade zum ersten Mal beigetreten ist. Die Doku beschreibt die Quarantäne nur für den Rejoin. Im Labor galt sie auch nach dem ersten Beitritt. Mit dem Default von 3.600 Sekunden heißt das in der Praxis, dass ein frisch gestarteter oder neu hinzugefügter Knoten eine Stunde lang nicht ausgeschlossen wird.
Nach Ablauf der Quarantäne ging es schnell. Um 07:32:42 verließ gr3 die Gruppe und startete sofort den Auto-Rejoin, der nach dem Ende der Sperre gelang.
07:32:42 [ERROR] [MY-015569] ... 'Member exiting group: applier channel lag of 103 seconds exceeded tolerance threshold configured to 10 seconds.'
07:32:42 [System] [MY-013373] ... 'Started auto-rejoin procedure attempt 1 of 3'
07:33:58 [System] [MY-013375] ... 'Auto-rejoin procedure attempt 1 of 3 finished. Member was able to join the group.'
Der Rejoin hängt an group_replication_autorejoin_tries, in 9.7 standardmäßig 3. Ist der Wert 0, greift group_replication_exit_state_action, im Labor OFFLINE_MODE.
Worauf wartet der Applier?
Nach dem Rejoin zeigt die neue Tabelle replication_applier_metrics, wie der Applier auf gr3 die aufgestaute Arbeit abgearbeitet hat. Die Komponente liefert nur mit Multi-Threaded Applier Daten, im Labor lief replica_parallel_workers mit dem Wert 4.
-- Aufruf mit mysql --vertical
SELECT * FROM performance_schema.replication_applier_metrics;

CHANNEL_NAME: group_replication_applier
TRANSACTIONS_COMMITTED_COUNT: 2052
WAITS_FOR_WORK_FROM_SOURCE_COUNT: 99
WAITS_FOR_AVAILABLE_WORKER_COUNT: 0
WAITS_COMMIT_SCHEDULE_DEPENDENCY_COUNT: 2034
WAITS_COMMIT_SCHEDULE_DEPENDENCY_SUM_TIME: 182865439436
WAITS_WORKER_QUEUES_FULL_COUNT: 0
WAITS_DUE_TO_COMMIT_ORDER_COUNT: 6
Von 2.052 Transaktionen mussten 2.034 auf eine Abhängigkeit warten, bevor sie einem Worker übergeben wurden. Vier Worker standen also bereit, konnten aber kaum parallel arbeiten. Eine naheliegende Erklärung liefert die Last selbst. Alle Zeilen verweisen auf staff_id 1 und die Writesets enthalten auch die Schlüssel referenzierter Parent-Zeilen. Gegengetestet habe ich diese Vermutung nicht. Genau diese Art von Befund war bisher nur mit Aufwand zu gewinnen. Wer mehr Worker konfiguriert, ohne die Abhängigkeiten zu kennen, gewinnt nichts.
Beim Failover soll der aktuellste Knoten Primary werden
Bisher entschied Group Replication beim Failover nach Version, Gewicht und schließlich der niedrigsten UUID. Die Komponente elect_prefers_most_updated stellt die Aktualität an die erste Stelle. Gewählt wird der Secondary mit dem kleinsten Rückstand, erst bei Gleichstand gelten Gewicht und UUID. Das funktioniert nur im Single-Primary-Modus und nur, wenn die Komponente auf allen Mitgliedern installiert und aktiviert ist.
Im Labor habe ich gr1 mit podman kill hart gestoppt. Neuer Primary wurde gr2, die Statusvariablen dort zeigen das Ergebnis.
SHOW STATUS LIKE 'Gr_latest_primary_election%';

+---------------------------------------------------------------+----------------------------+
| Variable_name                                                 | Value                      |
+---------------------------------------------------------------+----------------------------+
| Gr_latest_primary_election_by_most_uptodate_member_timestamp  | 2026-10-21 07:37:19.253563 |
| Gr_latest_primary_election_by_most_uptodate_members_trx_delta | 0                          |
+---------------------------------------------------------------+----------------------------+
Die Logmeldung erklärt, wie es dazu kam.
[System] [MY-015575] [Repl] Plugin group_replication reported:
'Member with uuid 44bd53b4-cd21-11f1-8d71-fabfa0083323 was elected primary since it was the most up-to-date member with 0 transactions more than second most up-to-date member 44e22711-cd21-11f1-8e5a-c270f7a36426. In case of a tie member weight and then uuid lexical order was used over the most updated members.'
Beide Secondaries waren gleich aktuell, also entschieden Gewicht und UUID. Das ist kein spektakuläres Ergebnis, aber ein ehrliches. Obwohl ich gr2 vor dem Failover kurz blockiert hatte, gab es aus Sicht der Komponente keinen Rückstand. Die Doku spricht vom Backlog des Secondary, ohne zu sagen, ob empfangene oder angewandte Transaktionen zählen. Diese Frage hat mein Labor nicht abschließend geklärt. Wer sich auf die Wahl nach Aktualität verlassen will, sollte das mit der eigenen Last testen und die beiden Statusvariablen nach jedem Failover auswerten.
Fallstricke
Der Resource Manager überwacht den Primary nicht. Laut Doku kann es im Grenzfall passieren, dass ein Secondary ausgeschlossen wird, während er gerade zum neuen Primary gewählt wird. Auto-Eviction setzt außerdem mindestens drei Mitglieder voraus. Bei zu engen Schwellwerten droht ein Dominoeffekt, wenn mehrere Secondaries unter derselben Last gleichzeitig zurückfallen. Wer von 8.4 kommt, sollte zudem die neuen Defaults im Blick behalten, denn group_replication_ssl_mode steht in 9.7 auf REQUIRED. Schließlich behebt 9.7.4 einen Fehler, bei dem eine Gruppe nach einer Netzwerkpartition das Quorum verlieren und in einer Reconnect-Schleife hängen konnte, die Schreibzugriffe blockierte.
Empfehlungen
- Installiert die Komponenten vor dem Beitritt eines Knotens zur Gruppe, auf allen Mitgliedern.
- Führt Flow-Control-Statistik und Applier-Metriken zuerst ein und speichert die Werte extern. Beide liefern sofort Nutzen, ohne in den Betrieb einzugreifen.
- Aktiviert den Ausschluss erst danach, mit Schwellwerten, die ihr aus der eigenen Messreihe ableitet. Berücksichtigt dabei die Quarantäne nach jedem Beitritt.
- Nutzt die Wahl nach Aktualität, wenn Datenverlust beim Failover das größere Risiko ist und prüft nach jedem Failover die Statusvariablen.
Fazit
Die vier Komponenten machen Group Replication in der Community Edition deutlich transparenter. Flow Control und Applier-Wartezeiten sind jetzt direkt messbar. Der Resource Manager hat im Labor einen hängenden Knoten zuverlässig ausgeschlossen und wieder aufgenommen. Die Quarantäne nach dem Beitritt solltet ihr kennen, bevor ihr euch auf die Selbstheilung verlasst. Ein durchdachtes Monitoring ersetzen die Komponenten nicht, sie liefern ihm aber endlich die richtigen Daten.
Wie geht ihr heute mit hängenden Secondaries um? Ich bin gespannt auf eure Erfahrungen. In Teil 4 nehme ich den Hypergraph Optimizer unter die Lupe. Wer die Themen der Serie vertiefen möchte, findet sie auch im ORDIX-Seminar „MySQL Administration", in dem ich als Referent die Neuerungen der aktuellen LTS-Version behandle.
Quellen
MySQL 9.7 Release Notes: Changes in MySQL 9.7.0
MySQL 9.7 Release Notes: Changes in MySQL 9.7.4
MySQL 9.7 Reference Manual: Group Replication Resource Manager Component
MySQL 9.7 Reference Manual: Group Replication Primary Election Component
MySQL 9.7 Reference Manual: Group Replication Flow Control Statistics Component
MySQL 9.7 Reference Manual: Replication Applier Metrics Component
Oracle: Improve Primary Selection on Failover in MySQL Group Replication
Seminarempfehlung
MYSQL ADMINISTRATION [DB-MY-01]
Mehr erfahren
Chief Transformation Officer & Principal Consultant bei ORDIX
Kommentare